Opdrachten ontwerpen waarbij menselijk denken nodig blijft
Tina Austin schrijft in het artikel “When AI Agents Can Complete the Assignment: Practical Strategies for Designing Tasks That Still Require Human Thinking” hoe je opdrachten voor lerenden kunt ontwerpen nu AI-agenten zelfstandig kunnen inloggen bij een leeromgeving, opdrachten maken en het resultaat inleveren.
Volgens Austin heeft AI geen nieuw probleem gemaakt, maar een bestaand probleem zichtbaar gemaakt. Veel opdrachten meten alleen of een taak is afgerond en niet of de lerende heeft nagedacht. Dat geldt volgens haar vooral voor drie soorten opdrachten:
- opdrachten waarin je informatie opzoekt, samenvat of rapporteert;
- opdrachten die vooral beoordeeld worden op verzorging, zoals taal, opbouw en bronvermelding;
- opdrachten waarin niet te zien is welke keuzes de lerende onderweg maakte.
Bij zulke opdrachten is het eindproduct van een lerende die zelf nadacht niet te onderscheiden van dat van een lerende die een AI-gegenereerd antwoord overnam.
Lerenden kunnen het denken daarbij ook te veel uitbesteden en daardoor zelf minder leren. AI verbieden of de AI-tools inperken helpt volgens Austin weinig, want AI-bedrijven concurreren juist op extra mogelijkheden. Detectiesoftware helpt ook niet: die kijkt naar het product en niet naar het proces. Bovendien leidt dit tot onterechte beschuldigingen, terwijl AI-gebruik eveneens wordt gemist. Onbegeleid AI-gebruik hangt volgens haar samen met zwakker kritisch denken, terwijl gestructureerd gebruik het redeneren juist kan versterken. Het verschil zit dus in het ontwerp van de opdracht, aldus Austin.
Zij gebruikt de zwakke punten van AI-agenten als uitgangspunt voor het ontwerp. Een agent:
- onthoudt niet wat een lerende eerder in de cursus heeft beweerd;
- weet niet wat er in een bepaald lokaal, lab of onderzoek is gebeurd;
- klinkt zelfverzekerd, ook als hij ongelijk heeft;
- spreekt zichzelf soms tegen in antwoorden die bij elkaar horen;
- geeft snel toe als je kritisch doorvraagt;
- kan geen echte reeks eigen keuzes navertellen.
De auteur verbindt deze zwakke punten met tien bekende AI-problemen, zoals verzonnen informatie, vooroordelen, overmatig vertrouwen en het ontbreken van eigen ervaring. Opdrachten waarbij lerenden over meerdere, met elkaar samenhangende antwoorden duurzaam moeten blijven redeneren, eerlijk moeten zeggen wat ze niet zeker weten, bij hun standpunt moeten blijven en moeten werken met de specifieke context van de leereenheid, maken volgens Austin direct gebruik van deze zwakke punten van AI.
Austin baseert haar aanpak op UnBlooms. Dat is een raamwerk dat zij eerder ontwikkelde als alternatief voor de taxonomie van Bloom. De kern is een herhaalde lus: een vraag stellen, een antwoord laten genereren, dat antwoord kritisch bekijken en het verbeteren. De lerende denkt tijdens elke stap na over de eigen aanpak. AI-uitvoer is daarbij ruw materiaal dat de lerende moet beoordelen en controleren.
Voor de invoering in het onderwijs draagt de docent de verantwoordelijkheid stap voor stap over:
- week 1 en 2: de docent laat hardop zien hoe je een goede vraag stelt;
- week 3 en 4: de groep beoordeelt samen AI-uitvoer;
- week 5 en 6: lerende werken in tweetallen;
- vanaf week 7: lerenden doorlopen de hele lus zelfstandig.
De docent beoordeelt dan het proces van redeneren in plaats van het eindproduct.
Het zogenaamde Multi-Stage AI Interaction Protocol maakt het denkproces vervolgens zichtbaar. Vóór elk AI-gebruik schrijft de lerende eerst een eigen standpunt, hypothese of voorspelling op. Daarna volgen vijf onderdelen:
- Basisantwoord. De lerende mag hiervoor AI gebruiken en plakt de uitkomst letterlijk in het document.
- Twee beperkingen. De lerende benoemt twee specifieke omstandigheden die zijn eigen denken vormden. Algemene antwoorden scoren laag, omdat AI de situatie van deze lerende niet kent.
- Beslismoment. De lerende beschrijft één moment waarop hij een AI-suggestie afwees of zijn aanpak veranderde. Dit onderdeel is de kern. Het vraagt om oordeelsvermogen en kan niet door AI worden nagebootst.
- Reflectie zonder AI. De lerende schrijft op welk deel het moeilijkst zou zijn geweest zonder AI.
- Zekerheidsscore. De lerende geeft aan hoe zeker de lerende is (0 tot 100 procent) en wat die score tien procent hoger zou maken.
Beoordeeld wordt op samenhang en specifiek zijn, niet op de vraag of het antwoord juist is.
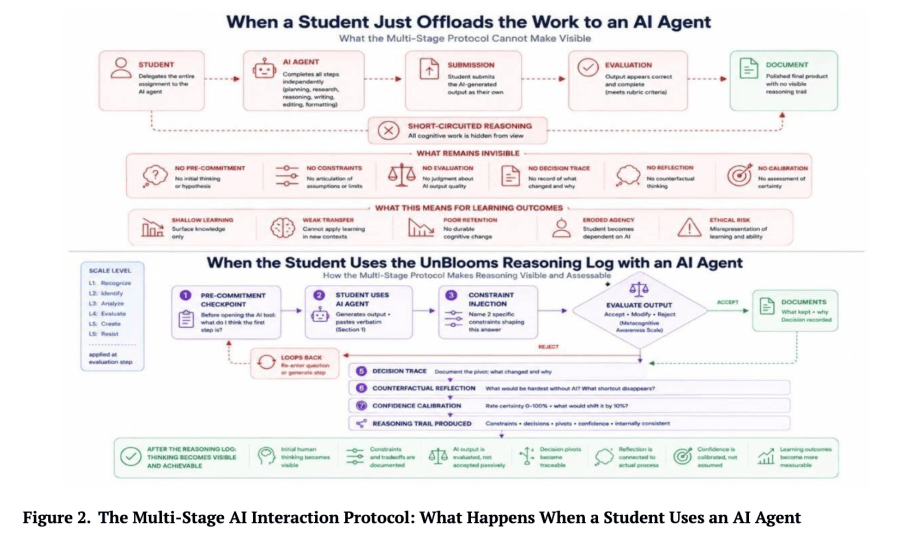 Bron: Austin, T. (2026). When AI Agents Can Complete the Assignment: Practical Strategies for Designing Tasks That Still Require Human Thinking. Journal of Instructional Design and Technology, 1(2), 8-18.
In haar bijdrage geeft Austin ook een voorbeeld van deze aanpak. Bij een biologiepracticum over enzymkinetiek kan een agent een gewoon verslag in twee minuten schrijven. In de nieuwe opzet voorspelt de lerende eerst, zonder AI, hoe de eigen Michaelis-Mentencurve eruit zal zien. Daarna noemt de lerende lokale omstandigheden, zoals een temperatuurschommeling in het lab en licht afgebroken substraat. Ten slotte legt de lerende uit waarom hij de AI-verklaring voor een afwijkende meting verwierp: de pipet bleek bij de derde meting verkeerd gekalibreerd. Zulke details kent een agent niet. Het artikel geeft ook aangepaste voorbeelden voor opgaven in de exacte vakken, voor betogende essays en voor projectwerk.
Voor de beoordeling stelt Austin een schaal van vijf niveaus voor:
- herkennen dat AI anders redeneert dan mensen;
- fouten opsporen;
- veronderstellingen analyseren;
- bredere gevolgen afwegen;
- iets nieuws ontwerpen, zoals een eigen controlemethode, of er bewust voor kiezen om zonder AI te werken.
Daarnaast introduceert zij de zogenaamde Discernment Rate: het deel van de AI-uitvoer dat een lerende bevraagt, betwist of aanpast. Ligt dit over vijf opdrachten dicht bij nul, dan zegt dat volgens Austin niets over fraude. Het laat zien dat de opdrachten te weinig denkwerk vragen.
Lerenden melden dat het vooraf opschrijven van hun eigen mening hun gebruik van AI verandert. Ze merken ook sneller wanneer ze uit gewoonte naar de tool grijpen. Dit werkte niet:
- reflectievragen die pas na afloop worden gesteld;
- algemene logboeken, die AI zelf kan invullen;
- detectiesoftware in plaats van een nieuw ontwerp;
- een eenmalige aanpassing zonder vervolg.
Austin adviseert om met één opdracht te beginnen, eerst de beoordelingscriteria aan te passen en te letten op samenhang tussen de onderdelen.
De auteur erkent dat het raamwerk alleen binnen losse cursussen is toegepast. Onderzoek over instellingen heen, onderzoek naar de mate waarin verschillende beoordelaars tot hetzelfde oordeel komen en gegevens over langere tijd ontbreken nog. Haar conclusie is dat opdrachten die zichtbaar redeneren vragen, moeilijker te omzeilen zijn dan opdrachten die een gepolijst eindproduct belonen.
Mijn opmerkingen
Het mooie van deze benadering is dat Tina Austin kiest voor een onderwijskundige aanpak van dit vraagstuk. Zij blijft weg van het ‘fraude naratief’ en zoekt de oplossing niet in het verbieden van AI-tools of het gebruik van bekritiseerde detectiesoftware. Het Multi-Stage AI Interaction Protocol is bovendien te combineren met andere aanpakken, zoals de mondelinge verdediging of het samenstellen van een portfolio. Opvallend is ook dat de auteur AI-tools expliciet gebruikt bij opdrachten. Het is overigens niet duidelijk of Austin’s protocol in de praktijk ook werkt. Kun je een AI-tool niet ook gebruiken om de twee beperkingen te formuleren of om een fictief beslismoment te verzinnen? En wat doe je als de bestaande ‘zwaktes’ van AI-tools verminderen of verdwijnen?
Mijn bronnen over (generatieve) artificiële intelligentie
Deze pagina bevat al mijn bijdragen over (generatieve) artificiële intelligentie.
Lees het hele
artikel